miércoles, 18 de noviembre de 2026

Agentes de IA con mente colectiva que aprenden mientras duermen

 Por Juan José de Haro

Los agentes de inteligencia artificial que trabajan en el ordenador, como Claude Code, Codex o Antigravity, empiezan cada sesión sin recordar nada de la anterior. Lo que se les explicó ayer sobre un proyecto, una corrección o la forma de trabajar de la persona que los usa se pierde al cerrar la conversación, y hay que repetirlo. Una forma de evitarlo es organizar lo que necesitan saber en varias capas, de modo que cada sesión empiece sabiendo lo importante. Este artículo describe un sistema de este tipo, de dónde salen sus ideas y qué hace falta para montarlo.

Actualizado el 8 de noviembre de 2026: el repaso de la memoria pasa de semanal a diario, los agentes funcionan como una mente colectiva y un buscador común les permite consultar las conversaciones de todos.

Pódcast del artículo realizado por Gemini Notebook

El olvido entre sesiones

Un agente trabaja con lo que cabe en su contexto, que es el texto que el modelo tiene delante en cada momento: las instrucciones, la conversación y los archivos que ha leído. Al terminar la sesión, ese contexto desaparece. Las herramientas ofrecen algunos remedios, como un archivo de instrucciones que se lee al empezar o una memoria donde el agente apunta lo que aprende, pero cada remedio por separado tiene un problema. Si se carga todo al empezar, el contexto se llena de información que casi nunca hace falta. Si se apunta sin orden, las notas se contradicen, se duplican y se quedan viejas.

El 6 de noviembre de 2026, Anthropic publicó un artículo de Lance Martin, «The components of agent memory», que ordena el problema en cuatro capas. Además, propone un proceso de consolidación al que llama dreaming (soñar). El sistema que se describe aquí sigue esa misma estructura, adaptada a un ordenador personal y sin servicios de pago aparte de la suscripción al agente.

Las cuatro capas de la memoria

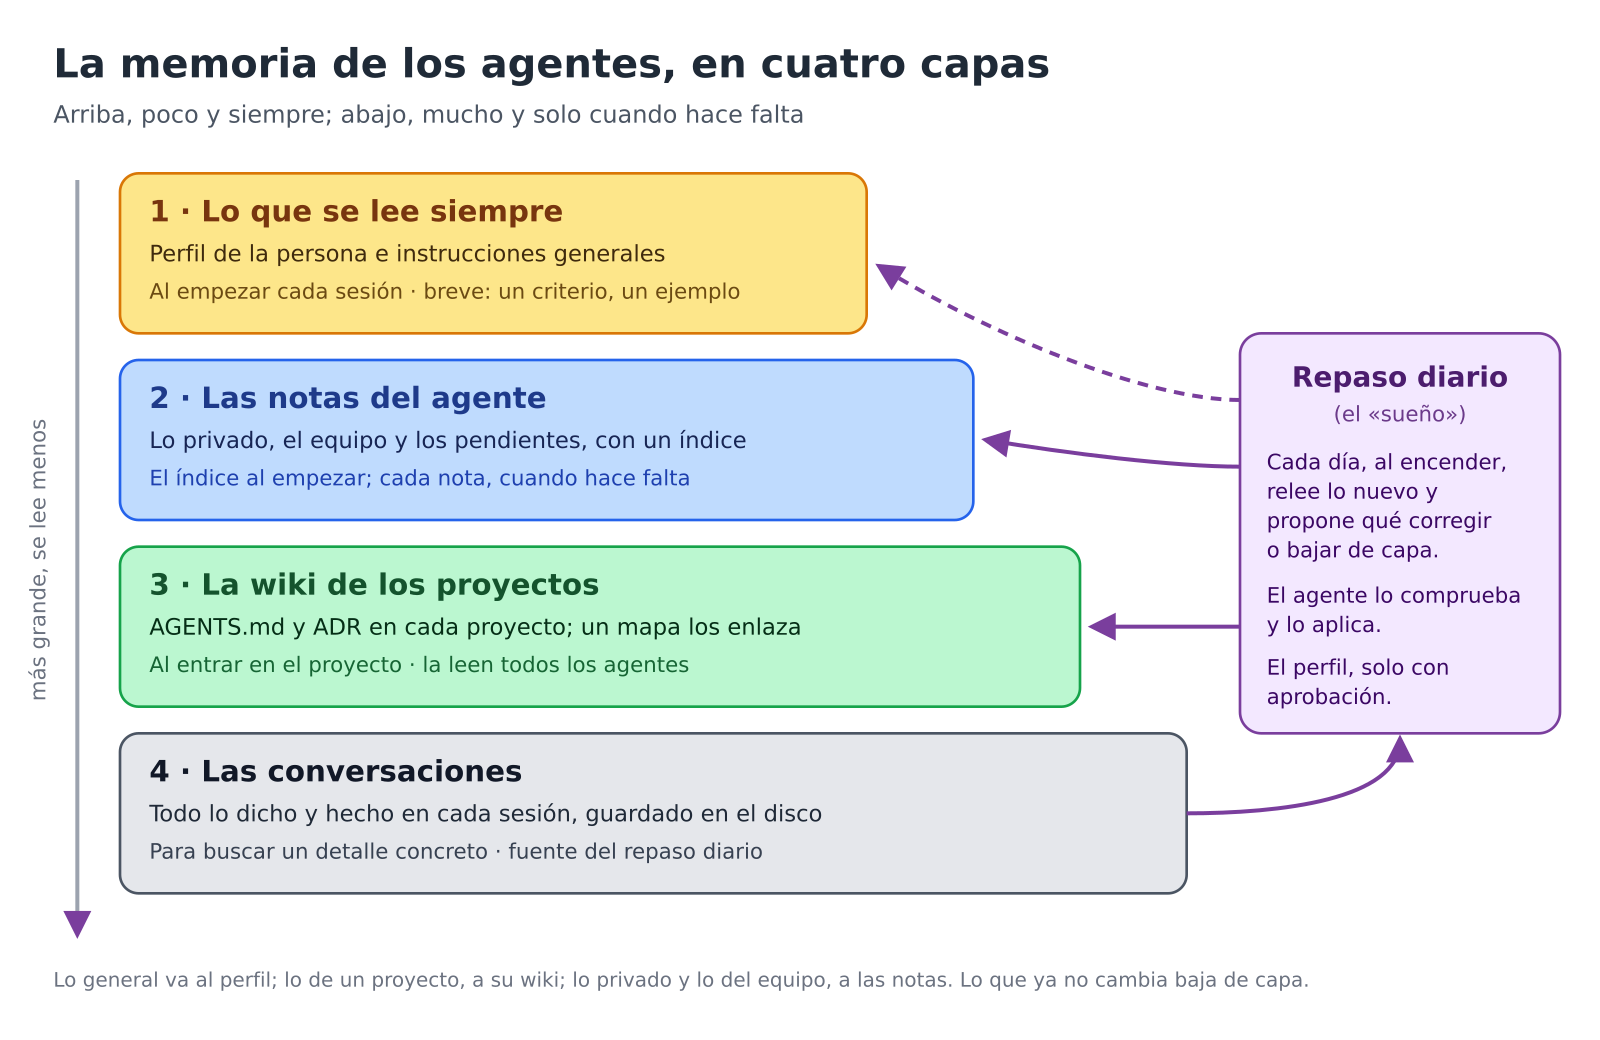
Cada capa guarda un tipo de información y se lee en un momento distinto. Las de arriba son pequeñas y se leen siempre; las de abajo son grandes y se consultan solo cuando hace falta.
Lo que se lee siempre

La primera capa es un perfil con la forma de trabajar y de decidir de la persona: qué le importa, cómo quiere que se le presenten las propuestas y qué errores no quiere que se repitan. Junto al perfil van unas instrucciones generales, por ejemplo dónde se guardan los informes o qué hacer antes de publicar algo. Todos los agentes lo leen al empezar cada sesión, y por eso tiene que ser breve. Cada criterio se anota una sola vez, con un único ejemplo, y lo amplían los propios agentes cuando la persona corrige algo o aprueba una propuesta. Solo entra lo general, lo que serviría igual en cualquier otro trabajo. El agente puede sacar un primer perfil de las conversaciones que ya tenga guardadas; solo un agente recién instalado empieza con el perfil vacío, y entonces se llena con el uso, con cada corrección o aprobación de la persona.

Las notas del agente

La segunda capa es la memoria del agente: notas cortas, una por tema, con un índice que el agente lee al empezar y que le dice qué hay en cada nota. Claude Code la trae activada y carga al empezar las primeras 200 líneas del índice; el resto de notas las abre cuando las necesita. Aquí va lo privado y lo del propio equipo: qué servidores hay, dónde están las credenciales (nunca las contraseñas), qué trucos tiene cada herramienta y qué tareas quedaron pendientes.

Las tareas pendientes con fecha se recuerdan con un pequeño programa que se ejecuta al abrir cada sesión y que en Claude Code se llama hook (gancho). Si la tarea es de la persona, el aviso aparece una vez al día como mucho. Si es trabajo del agente, se le pasa a él, que la hace y solo cuenta el resultado.

La wiki de los proyectos

La tercera capa está formada por documentos dentro de cada proyecto, en la misma carpeta que su código o su contenido:

  • El archivo AGENTS.md recoge lo que hay que saber para trabajar en ese proyecto: cómo se prueba, dónde se publica, qué no se puede olvidar. Es un formato abierto que mantiene la Agentic AI Foundation, de la Linux Foundation, y que leen Codex, Claude Code y otros agentes al entrar en la carpeta.
  • Los ADR, siglas en inglés de Architecture Decision Record (registro de decisiones de arquitectura), guardan el porqué de cada decisión importante y las alternativas que se descartaron. El formato lo propuso Michael Nygard en 2011 en «Documenting Architecture Decisions», y la guía Vibe coding responsable explica cómo usarlos al programar con IA.

Estos documentos se actualizan en el mismo cambio que la decisión que recogen, y por eso no se quedan viejos con tanta facilidad como una copia guardada en otro sitio. Por encima de todos ellos hay un mapa de proyectos, con una ficha por proyecto que recoge su estado, sus temas y los enlaces a su AGENTS.md y a sus ADR. El mapa tiene un buscador que mira a la vez en las fichas y en todos esos documentos. Es la misma idea que Andrej Karpathy describe en «LLM Wiki»: un conjunto de archivos Markdown enlazados que la propia IA mantiene al día.

Las conversaciones

La cuarta capa son las conversaciones completas, que los agentes guardan en el disco. Son el material en bruto: no se leen en cada sesión, pero cualquier agente puede consultarlas cuando hace falta recuperar lo que se dijo o se decidió en una sesión concreta, y son la fuente del repaso diario. Como cada agente las guarda a su manera, en formatos distintos y llenas de resultados de las herramientas, conviene un pequeño buscador común: reúne las conversaciones de todos los agentes y, ante una pregunta, devuelve solo los fragmentos del diálogo que tratan de ella, con su fecha y su proyecto. Lo programa el propio agente, y las instrucciones generales de todos indican cómo usarlo. Conviene comprobar cuánto tiempo las guarda cada agente: Claude Code, por ejemplo, las borra a los 30 días si no se amplía ese plazo en sus ajustes.

Una mente colectiva

Cada sesión es, en la práctica, un agente nuevo: empieza sin recordar nada y desaparece al cerrarla. Con este sistema, al empezar recibe lo que han aprendido todas las sesiones anteriores, de ese mismo agente o de otro, como Claude Code, Codex o Antigravity. Lee el mismo perfil, la misma wiki y puede buscar en todas las conversaciones. Ese conocimiento cambia su forma de trabajar desde el primer momento, y lo que aprende durante la sesión vuelve al conjunto con sus notas y con el repaso diario. El resultado se parece al colectivo Borg de Star Trek: muchos individuos que comparten una misma memoria. Pero cada sesión conserva su individualidad: razona por su cuenta, puede equivocarse y lo que aporta se revisa antes de entrar en el perfil.

Dónde va cada cosa

Con varias capas, la duda frecuente es dónde apuntar algo nuevo. La regla es sencilla: lo general sobre la persona va al perfil; lo de un proyecto, a su AGENTS.md o a un ADR; lo privado y lo del equipo, a la memoria del agente. Hay que tener en cuenta que muchos proyectos son públicos, así que en su AGENTS.md no puede aparecer nada personal, como direcciones de la red de casa, nombres o cuestiones económicas.

La información también cambia de capa con el tiempo. Una nota que empezó en la memoria mientras se probaba algo pasa al AGENTS.md del proyecto cuando ya no cambia, y desde ahí la ven todos los agentes, no solo el que la apuntó. Esta regla está escrita en las instrucciones generales de todos los agentes, para que cualquiera de ellos la aplique.

El repaso diario

Durante el día los agentes apuntan con prisa, en medio del trabajo, y algunas notas salen mal o se quedan viejas. El artículo de Anthropic propone un proceso de consolidación, inspirado en lo que hace el cerebro durante el sueño, que repasa las conversaciones y las notas para corregir errores y reorganizar lo aprendido. En sus pruebas, una wiki construida así hizo que el agente pasara de responder bien el 13 % de las preguntas sobre un conjunto de documentos al 48 %.

El ejemplo de Anthropic hace el repaso cada noche. En un ordenador personal, que de noche suele estar apagado, se hace una vez al día en cuanto se enciende: el día del repaso empieza de madrugada, a una hora en que el equipo nunca está en marcha, y un programa comprueba cada pocos minutos si ya se ha hecho. Si no, lanza un agente que lee lo que ha escrito la persona en todas las conversaciones desde el repaso anterior y lo compara con el perfil, las notas y la wiki. Si ese día no ha habido conversaciones, no lanza nada. Busca criterios que nadie apuntó, notas que ya no son ciertas, duplicados e información que debería bajar de capa. El agente del repaso solo puede leer y escribir un archivo, así que no cambia nada: deja una propuesta por escrito, con el texto actual y el propuesto en cada punto. Las instrucciones que recibe el agente del repaso están en el archivo repaso-diario-memoria.txt. No hace falta tocarlas: el agente que monta el sistema las adapta al ordenador.

En la siguiente sesión, el agente revisa esa propuesta y comprueba cada punto antes de aplicarlo, porque el repaso también se equivoca: en el primero, que abarcó una semana entera, uno de sus once hallazgos era falso. Lo que toca a la memoria y a la wiki lo aplica directamente. Los cambios del perfil los presenta a la persona, todos juntos y con el texto actual al lado del propuesto, y no se aplican hasta que los aprueba.

Anthropic ofrece este proceso como servicio en su plataforma para desarrolladores, con un ejemplo publicado que se paga por uso. Con un agente instalado en el ordenador, en cambio, el repaso corre con la misma suscripción que el resto del trabajo.

La copia de seguridad

Todo esto vive en archivos del ordenador: el perfil, las notas, las conversaciones, los ajustes de los agentes y la lista de tareas programadas. Por eso conviene incluirlo en la copia de seguridad, cifrada, porque las conversaciones contienen de todo. Conviene también tener por escrito cómo recuperarlo en otro ordenador, con los pasos en orden, para que un cambio de equipo no obligue a empezar de cero.

Límites y precauciones

El sistema tiene algunos inconvenientes que conviene conocer:

  • El perfil y el índice cuestan contexto. Todo lo que se carga al empezar ocupa espacio en cada sesión, y un error apuntado ahí se repite en todas. Por eso esas dos piezas tienen que ser breves y revisarse.
  • El repaso se equivoca. Sus propuestas se comprueban antes de aplicarlas, y el perfil necesita la aprobación de la persona.
  • Las conversaciones son sensibles. Contienen todo lo que se ha dicho y todo lo que el agente ha leído, así que no deben salir del ordenador sin cifrar.
  • Cada herramienta guarda su memoria a su manera. La memoria de Claude Code no la lee Codex, y al revés. Lo que deben saber todos los agentes tiene que ir al perfil o a la wiki, que sí leen todos.

Qué hace falta para montarlo

Solo hace falta un agente instalado en el propio ordenador, en su versión de consola o de escritorio, como Claude Code, Codex o Antigravity. No hace falta ningún servidor: el repaso diario se hace al encender el ordenador. El artículo «Consolas de IA: qué son y cómo se instalan» explica cuáles hay y cómo se instalan. En las versiones web no funciona, porque no pueden leer ni escribir los archivos del ordenador, que es donde vive la memoria.

No hay que montarlo a mano. Se le da al agente una sola vez el prompt que viene a continuación: él crea todas las piezas y solo pregunta lo que no puede saber. Desde ese momento, cada sesión nueva trabaja con este sistema, y lo único que hay que hacer es aprobar o rechazar los cambios del perfil que proponga el repaso diario.

Lee el artículo https://educacion.bilateria.org/agentes-de-ia-que-aprenden-mientras-duermen y monta en este ordenador su sistema de memoria, adaptado a mí. Decide tú los detalles técnicos, eligiendo siempre lo más sencillo y seguro, y créalo todo: el perfil, las notas, el aviso de tareas pendientes, el buscador de conversaciones, el repaso diario y la copia de seguridad. Si en este ordenador hay otros agentes, como Codex o Antigravity, haz que compartan el mismo sistema. No uses servicios de pago aparte de la suscripción: nada de la API. Para el repaso, parte de las instrucciones que enlaza el artículo; el agente del repaso solo puede leer archivos y escribir su propuesta. Asegúrate también de que las conversaciones no se borren solas. Para empezar el perfil, lee las conversaciones que tengas guardadas y tu memoria, y apunta solo lo que yo haya dicho o hecho; si no hay nada, hazme como mucho tres preguntas cortas. El repaso no debe cambiar nada por su cuenta: lo que toque al perfil me lo enseñarás para que diga sí o no. Pregúntame solo lo que no puedas saber tú, de una en una, con preguntas de sí o no o con dos opciones explicadas en palabras sencillas. Al terminar, cuéntame en cinco líneas qué has montado, qué tendré que hacer yo de forma habitual y cómo deshacerlo si no me convence.

Referencias

Tomado de Bilateria 

martes, 17 de noviembre de 2026

Las máquinas también son audiencia: cómo adaptar la comunicación institucional a la inteligencia artificial

 Tomado de Universo Abierto

Speaker presenting artificial intelligence communication strategies beside humanoid robots
A speaker presents institutional communication strategies for artificial intelligence to an audience alongside humanoid robots.

Pew Research Center. (2026, 1 de octubre). Welcoming machines as audience: A guide for nonprofit communicators thinking about AI. Pew Research Center. Consultar artículo original

PDF

La idea fundamental es que la visibilidad institucional está cambiando: ya no basta con estar presente en Internet, también hay que ser comprensible, recuperable y reconocible para la inteligencia artificial. Las bibliotecas tienen aquí una nueva responsabilidad como intermediarias entre el conocimiento publicado, los sistemas inteligentes y los ciudadanos.

Se presenta una guía del Pew Research Center dirigida a profesionales de la comunicación de organizaciones sin ánimo de lucro, con recomendaciones para adaptar sus estrategias a un escenario en el que la inteligencia artificial se ha convertido en intermediaria entre las fuentes de información y los ciudadanos. Los usuarios recurren cada vez más a herramientas como ChatGPT y otros asistentes inteligentes para buscar información, resolver dudas y conocer el trabajo de diferentes instituciones. Este cambio está modificando la manera en que las personas descubren, interpretan y confían en los contenidos publicados en Internet.

La idea central es que las organizaciones ya no deben pensar exclusivamente en las personas como destinatarias de sus contenidos, sino también en los sistemas de inteligencia artificial que rastrean, interpretan, seleccionan y presentan esa información. Esto significa que las instituciones deben aprender a comunicar simultáneamente para dos públicos: los lectores humanos y las máquinas que procesan sus contenidos. La presencia de una organización en los resultados de los buscadores tradicionales ya no garantiza que también aparezca en las respuestas generadas por los asistentes de IA.

El documento propone una estrategia estructurada en tres líneas de actuación: aceptar, adaptar y avanzar (Accept, Adapt, Advance).

– Aceptar (Accept): reconocer que la inteligencia artificial ha llegado para quedarse y que una parte de los usuarios ya utiliza estos sistemas para acceder a la información. Las organizaciones deben asumir que este comportamiento puede afectar al tráfico directo hacia sus páginas web y a la manera en que se distribuyen sus contenidos.

– Adaptar (Adapt): analizar cómo aparecen actualmente los contenidos institucionales en las respuestas de los sistemas de IA. Se recomienda realizar pruebas con preguntas reales relacionadas con la actividad de la organización, utilizando diferentes plataformas. Es importante comprobar si la institución aparece mencionada, si sus documentos son citados y si se incluyen enlaces que permitan acceder a las fuentes originales.

– Avanzar (Advance): incorporar los resultados de estas evaluaciones a las futuras estrategias de comunicación. Esto implica mejorar la estructura, los metadatos y la accesibilidad de los contenidos para facilitar su interpretación por parte de los sistemas automatizados, sin descuidar las necesidades de los lectores humanos.

La guía incluye una lista de comprobación con recomendaciones prácticas. En primer lugar, propone decidir si interesa que los chatbots de inteligencia artificial utilicen y difundan los contenidos de la organización. Esta decisión debe estar vinculada a sus objetivos institucionales, identificando qué investigaciones, servicios, productos y públicos interesa hacer más visibles. También se debe definir qué resultados se esperan: respuestas precisas, atribución correcta de la autoría y enlaces que conduzcan a la fuente original.

En segundo lugar, recomienda evaluar la visibilidad institucional en los sistemas de IA mediante entre 10 y 20 preguntas reales que deberían permitir localizar los conocimientos, investigaciones o datos de la organización. Estas consultas deben probarse en distintas plataformas, registrando si la institución aparece, si recibe citas y enlaces y si la información recuperada es actual, correcta y completa. También conviene identificar errores, referencias desactualizadas, omisiones y problemas de atribución, repitiendo periódicamente las pruebas para observar la evolución.

Otro aspecto fundamental es la denominada legibilidad para las máquinas (machine readability). Pew Research Center recomienda que los datos representados en gráficos estén disponibles también como texto, que los metadatos describan claramente los temas, autores, periodos temporales y conjuntos de datos, y que los informes importantes dispongan de versiones en texto plano o Markdown. Asimismo, aconseja revisar las páginas web para detectar elementos que puedan dificultar el rastreo, la interpretación o la recuperación de la información por parte de los sistemas automatizados.

Finalmente, el documento propone medir los resultados mediante tres indicadores principales: visibilidad, precisión y generación de tráfico. No basta con que una herramienta de IA mencione una institución; también debe representar correctamente su información y facilitar el acceso a sus contenidos originales. Para ello, recomienda establecer responsables de seguimiento y realizar evaluaciones periódicas en las principales plataformas.

Lista de comprobación práctica para profesionales de organizaciones sin ánimo de lucro

1. ¿Quieres que las personas utilicen chatbots de inteligencia artificial para encontrar y conocer el trabajo de tu organización?

  • Analiza cómo la visibilidad en los sistemas de IA contribuye a la misión y a los objetivos de comunicación de tu organización.
  • Decide si quieres que los sistemas de inteligencia artificial accedan a tus contenidos y los muestren en sus respuestas.
  • Identifica los temas, productos y públicos para los que resulta más importante tener visibilidad en la IA.
  • Define los resultados que deseas conseguir: respuestas precisas, atribución clara de la autoría y enlaces que permitan regresar a tu organización y consultar sus fuentes originales.

2. ¿Cómo aparece actualmente tu trabajo en los sistemas de IA? ¿Es esa la visibilidad que deseas?

  • Selecciona entre 10 y 20 preguntas o instrucciones reales (prompts) que deberían permitir localizar tus conocimientos especializados, investigaciones o datos.
  • Prueba las mismas preguntas en diferentes plataformas de inteligencia artificial.
  • Registra si tu organización aparece mencionada, citada y enlazada.
  • Pide a un experto en la materia que evalúe si cada respuesta está actualizada y es precisa y completa.
  • Identifica patrones y problemas, como información desactualizada, atribuciones poco claras, enlaces ausentes o datos que los sistemas no consiguen recuperar.
  • Repite las pruebas periódicamente para comprobar qué aspectos cambian con el tiempo.

3. ¿Cómo puedes conseguir que tus contenidos sean legibles para las máquinas?

  • Adopta un flujo de trabajo simultáneo: continúa ofreciendo contenidos y servicios a las personas mientras preparas también la información para que pueda ser procesada por las máquinas.
  • Facilita que los datos y la información que aparecen en gráficos estén disponibles en formato de texto legible, y no únicamente como imágenes estáticas.
  • Mejora los metadatos para que los sistemas puedan identificar elementos como el tema, la población estudiada, los años que abarca la información, los informes, los conjuntos de datos y los autores.
  • Crea versiones en texto plano o Markdown de los principales informes para facilitar que las máquinas recuperen sus contenidos esenciales.
  • Audita tu sitio web para detectar cualquier elemento que pueda dificultar que los sistemas automatizados rastreen, interpreten o relacionen la información.

4. ¿Cómo puedes saber si estás teniendo éxito?

  • Comprueba que los motores de inteligencia artificial recuperan tu información (visibilidad), la representan correctamente (precisión) y generan tráfico hacia tu organización (enlaces).
  • Utiliza diferentes indicadores para evaluar los resultados, entre ellos pruebas basadas en preguntas (prompts), actividad de los rastreadores de IA, menciones, citas y tráfico procedente de referencias externas.
  • Designa a una persona responsable de realizar pruebas periódicas en las plataformas y modelos de inteligencia artificial más utilizados.

lunes, 16 de noviembre de 2026

¿Qué hacer cuando al alumnado le cuesta aprender un contenido concreto?

 Por Ángel Fidalgo

Imaginemos que un profesor considera que los motores de combustión son uno de los temas más importantes de su asignatura. Sin embargo, cuando revisa los ejercicios o escucha las preguntas en clase, comprueba que a su alumnado le cuesta aprender cómo funcionan.

En la metáfora del árbol, esto es un problema hoja. Son los problemas que el profesorado percibe con más facilidad porque aparecen ligados a un contenido concreto. Como la dificultad se manifiesta en ese tema, es fácil suponer que el origen está en el propio contenido. Y entonces, cuando nos proponemos innovar, lo primero que se nos ocurre es actualizar los materiales, incorporar algún recurso multimedia o diseñar una práctica.

Este enfoque tiene dos problemas principales:

La dificultad de transferir la mejora. Podemos diseñar una buena práctica sobre motores de combustión y, aun así, encontrar dificultades para que otro profesor la utilice, incluso si imparte la misma asignatura. La dificultad está en que ese profesor considere útil la propuesta para su grupo. Quizá le parezca una buena práctica, pero prefiera dedicar más tiempo a los motores eléctricos.

¿He innovado? A menudo, lo que presentamos como una innovación se queda en una actualización de contenidos o en el diseño de una práctica. Son tareas útiles, pero, como decía un ilustre profesor, renovar los contenidos es obligación, no innovación.

Pero este enfoque también tiene una gran ventaja: nos señala dónde empezar a innovar. En ese punto confluyen los contenidos, la forma de trabajarlos en clase y, en ocasiones, la tecnología que utilizamos. Es un buen sitio para separar la paja del grano y preguntarnos qué está dificultando el aprendizaje de ese tema. es decir, centrarnos más en los procesos. La respuesta puede ayudarnos a entender por qué ocurre algo parecido con otros contenidos.

Podemos empezar por buscar un problema rama, como la desmotivación. Si el tema no les interesa, ¿es porque no ven su utilidad? ¿Porque les faltan conocimientos previos y les cuesta seguirlo? ¿Puede influir nuestra forma de trabajarlo en clase?

También podemos llegar a un problema raíz, de los que origina el propio modelo educativo. Por ejemplo, si el alumnado se acostumbra a escuchar y tomar apuntes, ¿qué oportunidades tiene para participar, contrastar sus ideas y aprender con sus compañeros? Quizá eso ocurra al estudiar los motores y también en otros temas.

Así pues, si a nuestro alumnado le cuesta aprender cómo funciona un motor de combustión, ya sabemos por dónde empezar a mirar. Antes de preparar otra práctica, hagámonos una pregunta: ¿qué les está impidiendo aprenderlo? Quizá la respuesta nos sirva para mejorar algo más que el tema de los motores.

Tomado de Investigación e Innovación educativa

viernes, 13 de noviembre de 2026

La IA y las bibliotecas: por qué los bibliotecarios podrían convertirse en árbitros de la realidad

 Tomado de Universo Abierto

Friedman, Jane. (2026, 20 de abril). AI and Libraries: Why Librarians May Become Arbiters of Reality. Jane Friedman. https://janefriedman.com/ai-and-libraries-why-theyre-like-canaries-in-the-coal-mine/

Jane Friedman analiza el impacto de la inteligencia artificial generativa en las bibliotecas y en el ecosistema editorial, y plantea que los bibliotecarios podrían desempeñar una función decisiva en la defensa de la información fiable. El artículo parte de un seminario del Book Industry Study Group (BISG), en el que se presentaron datos sobre la adopción de la IA en el sector editorial y se debatió sobre sus consecuencias con el especialista en bibliotecas R. David Lankes.

La idea central es que las bibliotecas no se enfrentan a un riesgo meramente hipotético: ya están experimentando las consecuencias de la proliferación de contenidos generados automáticamente, la desinformación y la dificultad de distinguir entre materiales rigurosos y publicaciones de escasa calidad. Por ello, las bibliotecas pueden funcionar como un sistema de alerta temprana que permita identificar los problemas antes de que deterioren aún más la confianza en los recursos de información.

Uno de los resultados destacados de la encuesta del BISG es la resistencia relativamente elevada de los profesionales de las bibliotecas a la adopción de la IA. Aproximadamente un tercio de los bibliotecarios encuestados afirmó que no utilizaba estas herramientas y que tampoco tenía intención de hacerlo, frente al 20 % del conjunto de participantes de los distintos sectores analizados. Además, alrededor del 34 % manifestó una oposición ética a su utilización. Menos de la mitad señaló que su institución empleaba activamente IA, mientras que un 31 % desconocía si se estaba utilizando. La ausencia de políticas institucionales claras también aparecía como un problema relevante.

Friedman subraya que esta actitud crítica no debe interpretarse simplemente como miedo al cambio o falta de formación. Según las investigaciones de Lankes, algunos de los profesionales más reticentes conocen los modelos de lenguaje, comprenden cómo funcionan y pueden explicar técnicamente sus limitaciones. Sus objeciones se relacionan con la fiabilidad de los resultados, la calidad de los contenidos y la posibilidad de que la incorporación indiscriminada de estas tecnologías contradiga la misión fundamental de la biblioteca. La cuestión, por tanto, no consiste únicamente en aprender a utilizar la IA, sino en determinar cuándo su uso está justificado, qué valores debe respetar y qué consecuencias tiene para la calidad de los servicios bibliotecarios.

La autora evita adoptar una posición exclusivamente negativa y presenta un ejemplo que ilustra cómo la inteligencia artificial puede resolver problemas que, de otro modo, quedarían sin solución. En la Universidad de Texas existía una colección de miles de discos y grabaciones musicales que resultaba prácticamente invisible para los usuarios porque no se había podido catalogar por completo debido a la falta de recursos humanos. El equipo responsable recurrió a la IA para generar registros catalográficos preliminares, acompañados de indicadores de confianza que permitían estimar la fiabilidad de cada identificación. Los registros menos seguros podían reservarse para una revisión humana posterior, mientras que los materiales más utilizados se priorizaban para recibir una catalogación completa realizada por profesionales.

Este caso demuestra que el debate no debería reducirse a elegir entre utilizar o rechazar la inteligencia artificial. La pregunta relevante es si la tecnología permite ofrecer un servicio que, sin ella, no podría prestarse adecuadamente. Friedman establece un paralelismo con la accesibilidad editorial: las herramientas de IA pueden ayudar a producir descripciones de imágenes, mejorar metadatos y adaptar publicaciones para lectores con discapacidad cuando los recursos disponibles no permiten abordar todo ese trabajo de forma manual. La tecnología puede ampliar el acceso a la información, pero su incorporación debe estar acompañada de criterios de calidad, supervisión profesional y evaluación de resultados.

Uno de los argumentos más importantes del artículo se refiere a la dificultad de mantener los mecanismos tradicionales de evaluación y validación frente al crecimiento exponencial de los contenidos generados mediante IA. El sistema de revisión por pares, fundamental para la publicación científica, se ha desarrollado sobre la premisa de que la producción de conocimiento y la capacidad humana para revisarlo mantienen cierto equilibrio. Sin embargo, la IA permite generar textos, informes y publicaciones a una velocidad que supera ampliamente la capacidad de evaluación de los expertos.

El problema no consiste solo en que puedan producirse documentos incorrectos, sino en que resulta cada vez más difícil comprobar su calidad, procedencia y credibilidad. Tampoco basta con utilizar herramientas de inteligencia artificial para revisar automáticamente los contenidos generados por otras herramientas, puesto que la evaluación requiere criterios fiables y una capacidad de verificación independiente. Si la producción de información crece mucho más deprisa que los mecanismos para validarla, se debilitan las estructuras sobre las que se construye la confianza en el conocimiento científico y editorial.

La autora relaciona esta situación con la saturación del mercado de libros, donde el aumento de publicaciones generadas o asistidas por IA puede dificultar que los lectores encuentren obras de calidad. Cuando resulta más complicado confiar en materiales desconocidos, los usuarios pueden refugiarse en autores, fuentes y publicaciones que ya conocen. Esta tendencia reduce la visibilidad de nuevas voces y puede empobrecer la diversidad informativa y cultural.

El concepto más sugerente del artículo es la posibilidad de que los bibliotecarios se conviertan en arbiters of reality, expresión que puede traducirse como «árbitros de la realidad». La idea, vinculada a las reflexiones de R. David Lankes, no significa que los bibliotecarios deban decidir unilateralmente qué es verdadero o falso, sino que pueden ayudar a las personas a distinguir entre información documentada, afirmaciones dudosas y contenidos cuya procedencia no puede verificarse.

La biblioteca dispone de una ventaja fundamental frente a los sistemas automatizados: la mediación de profesionales que conocen las fuentes, comprenden los procesos de selección y organización documental y pueden explicar por qué un recurso resulta pertinente y fiable. Un bibliotecario puede identificar la procedencia de un documento, localizar la publicación original, contrastar distintas versiones y orientar al usuario hacia evidencias verificables. La confianza que las comunidades han depositado históricamente en las bibliotecas constituye, en este contexto, un recurso social de gran valor.

Friedman destaca una diferencia significativa entre recibir una respuesta generada por una IA y obtener orientación de un profesional bibliotecario. En el primer caso, el usuario necesita comprobar la exactitud de la respuesta y la validez de sus fuentes; en el segundo, puede contar con una persona capaz de explicar el proceso de búsqueda, contextualizar los resultados y asumir la responsabilidad profesional de la orientación ofrecida. La biblioteca puede convertirse así en un espacio de referencia y confianza en un entorno informativo donde la apariencia de seguridad de una respuesta ya no garantiza su veracidad.

Tomado de Universo Abierto

jueves, 12 de noviembre de 2026

La inteligencia artificial tiene voz, pero ¿tiene mirada? Hacia una pedagogía de la mirada

 Por Mercedes Leticia Sánchez Ambriz y Carlos Bravo Reyes


El rostro humano no es solamente una estructura anatómica. Es un territorio de comunicación donde las emociones encuentran formas de manifestarse sin necesidad de palabras. Una sonrisa puede transmitir tranquilidad; una expresión de sorpresa, admiración; y una mirada serena, confianza.

Pero ¿qué ocurre cuando trasladamos este lenguaje no verbal al ámbito educativo, precisamente en una época en la que la inteligencia artificial (IA) comienza a hablar, crear imágenes, interpretar información y reproducir expresiones humanas?

La pregunta adquiere especial relevancia porque estamos formando docentes capaces de utilizar herramientas tecnológicas cada vez más sofisticadas, pero quizá dedicamos menos atención a desarrollar una competencia profundamente humana: comunicar mediante la mirada, reconocer las necesidades emocionales de los estudiantes y expresar confianza en sus posibilidades de aprendizaje.

Esta reflexión nos invita a pensar en una pedagogía de la mirada, entendida como una perspectiva educativa que reconoce el valor de la comunicación no verbal, la expresividad emocional y la atención consciente hacia los estudiantes como elementos de la mediación pedagógica.

La inteligencia artificial tiene voz, pero ¿qué expresa su mirada?

La evolución de la inteligencia artificial generativa ha transformado nuestras posibilidades de comunicación y creación educativa. Actualmente podemos buscar y sintetizar información, diseñar simulaciones, elaborar pódcast, producir videos, construir narrativas digitales y transformar un contenido en diferentes formatos y canales de comunicación.

Incluso podemos conversar con sistemas que responden mediante voces naturales y observar avatares capaces de reproducir sonrisas, movimientos oculares y expresiones faciales. Sin embargo, existe una diferencia fundamental entre representar una emoción y experimentarla. El rostro humano no solamente muestra expresiones; también participa en una comunicación cargada de experiencias, intenciones y significados que construimos en nuestras relaciones con los demás.

Así, un avatar puede mostrar alegría, pero esa expresión no demuestra que experimente felicidad. Puede simular preocupación ante una respuesta equivocada, pero ello no equivale al compromiso afectivo de un docente que conoce las dificultades y los esfuerzos de sus estudiantes.

La IA puede identificar patrones de comunicación y generar respuestas adaptadas al contexto, pero no debemos confundir esa capacidad con una experiencia emocional humana, al respeto Miao y Holmes (2023), en la guía de la UNESCO sobre inteligencia artificial generativa en educación e investigación, destacan la necesidad de preservar la agencia humana y promover un uso ético y pedagógicamente pertinente de estas tecnologías.

Esto nos conduce a una reflexión: el desafío no consiste en conseguir que las máquinas parezcan cada vez más humanas, sino en evitar que nuestras prácticas educativas pierdan su dimensión humana al utilizarlas. La tecnología puede ampliar nuestra voz y multiplicar nuestras posibilidades de comunicación. Pero debemos preguntarnos si estamos cultivando con la misma intensidad la capacidad de escuchar, observar y reconocer al otro.

Los ojos también enseñan: el poder de la comunicación no verbal

Imaginemos dos docentes que explican el mismo tema.

El primero presenta información actualizada, utiliza recursos multimedia y desarrolla una exposición técnicamente impecable. Sin embargo, mantiene una expresión rígida, evita mirar a sus estudiantes y apenas modifica el tono de voz.

El segundo utiliza contenidos semejantes, pero acompaña sus explicaciones con expresiones naturales, observa las reacciones del grupo, sonríe ante una intervención creativa y transmite serenidad cuando alguien se equivoca.

Aunque ambos enseñan el mismo contenido, la experiencia emocional del aprendizaje puede ser diferente. La comunicación educativa no depende exclusivamente de las palabras. Los gestos, las expresiones faciales, el contacto visual, la postura corporal, la dicción, el ritmo y la entonación también forman parte del mensaje pedagógico.

Este fenómeno ha sido estudiado mediante el concepto de inmediatez docente, referido a los comportamientos comunicativos que contribuyen a reducir la distancia física o psicológica percibida entre profesores y estudiantes.

Liu (2021), en una revisión sistemática de 30 investigaciones, identificó asociaciones positivas entre la inmediatez verbal y no verbal del profesorado y la motivación estudiantil. Aunque los estudios revisados presentan diferentes diseños metodológicos, sus resultados destacan la relevancia de la comunicación interpersonal en los procesos formativos. Por su parte, Zheng (2021) analiza la claridad, la credibilidad y la inmediatez docente, así como sus relaciones con la motivación y el compromiso académico de los estudiantes.

Estos trabajos permiten reconocer que una mirada, una sonrisa o un gesto de aprobación no son elementos superficiales de la enseñanza: forman parte de las condiciones comunicativas mediante las cuales se construye la relación pedagógica. Una mirada puede invitar a participar. Una sonrisa puede reducir la tensión ante una equivocación. Un gesto de interés puede ayudar a que un estudiante se sienta escuchado.

No obstante, la comunicación no verbal debe interpretarse considerando las diferencias culturales e individuales. No todas las personas expresan confianza mediante el contacto visual directo, ni todas necesitan las mismas formas de interacción.

La pedagogía de la mirada no consiste en enseñar a mirar de una manera uniforme, sino en aprender a comunicar reconocimiento, respeto y sensibilidad hacia los demás.

Esta perspectiva también adquiere relevancia en los entornos virtuales, donde una cámara, una pantalla compartida o una interacción mediante audio modifican nuestras posibilidades de comunicación. La presencia pedagógica no depende únicamente de observar físicamente al estudiante, sino de demostrar atención a sus aportaciones, dificultades y necesidades, respetando sus condiciones de conectividad, accesibilidad y privacidad.

Hacia una pedagogía de la mirada en tiempos de IA

El marco de competencias en inteligencia artificial para docentes de la UNESCO, desarrollado por Miao y Cukurova (2024), propone cinco dimensiones formativas: pensamiento centrado en el ser humano, ética de la IA, fundamentos y aplicaciones, pedagogía de la IA y desarrollo profesional.

Este planteamiento constituye una base para reflexionar sobre las competencias que necesitamos fortalecer. Aprender a utilizar herramientas de IA es importante, pero también debemos desarrollar capacidades para comunicarnos con sensibilidad, comprender las necesidades educativas y establecer relaciones pedagógicas significativas.

Desde esta perspectiva, se proponen cuatro dimensiones para una pedagogía de la mirada:

Estas dimensiones constituyen una propuesta conceptual para la reflexión y la formación docente, no un modelo empírico validado.

Su aplicación podría desarrollarse mediante actividades de autoobservación, análisis de grabaciones de clases con consentimiento, ejercicios de comunicación no verbal y reflexiones sobre las interacciones con los estudiantes.

El propósito no sería evaluar quién sonríe más, sino comprender cómo construimos ambientes educativos emocionalmente seguros, donde las personas puedan expresar sus ideas, equivocarse y aprender con confianza.

En este sentido, la pedagogía de la mirada busca complementar las competencias digitales docentes con una dimensión humana que ninguna innovación tecnológica debería relegar.

Reflexión final: enseñar también es aprender a mirar

Es posible que los estudiantes olviden el nombre de una aplicación, una presentación o una explicación. Sin embargo, pueden conservar durante mucho tiempo el recuerdo de un docente que los escuchó, que mostró confianza en sus capacidades y que transmitió entusiasmo por aprender.

En una época en la que las máquinas pueden generar millones de palabras y reproducir rostros cada vez más realistas, quizá debamos recuperar el valor de aquello que comunicamos sin hablar.

La inteligencia artificial puede tener voz, rostro y una mirada simulada. Pero nuestra responsabilidad como docentes es cultivar una mirada que reconozca, inspire y acompañe, porque educar no consiste únicamente en transmitir conocimientos o dominar tecnologías, también es aprender a mirar al otro con humanidad.

Referencias

Liu, W. (2021). Does teacher immediacy affect students? A systematic review of the association between teacher verbal and non-verbal immediacy and student motivation. Frontiers in Psychology, 12, Article 713978. https://doi.org/10.3389/fpsyg.2021.713978

Miao, F., & Cukurova, M. (2024). AI competency framework for teachers. UNESCO. https://unesdoc.unesco.org/ark:/48223/pf0000391104

Miao, F., & Holmes, W. (2023). Guidance for generative AI in education and research. UNESCO. https://unesdoc.unesco.org/ark:/48223/pf0000386693

Zheng, J. (2021). A functional review of research on clarity, immediacy, and credibility of teachers and their impacts on motivation and engagement of students. Frontiers in Psychology, 12, Article 712419. https://doi.org/10.3389/fpsyg.2021.712419 

Tomado de 366-días